

Samsung er på vej ind i en ny fase
Samsung står over for et vendepunkt denne måned. Diskret, næsten under fyrværkeriet fra det kinesiske nytår, kan virksomheden begynde masseproduktionen af HBM4—dens mest betydningsfulde hukommelsesgeneration til dato.
Disse høj båndbredde-hukommelseschips er ikke en lille opgradering. De udgør rygraden i næste generation af AI-acceleratorer. Nvidias Vera Rubin-arkitektur, designet til generativ AI i hyperscaler-skala, forventes at være afhængig af HBM4 for at presse latenstiden ned og båndbredden op. Rapporterne tyder på, at leverancer til Nvidia kan begynde så tidligt som i næste uge.
Hvorfor betyder det noget? Fordi hukommelsen ofte er flaskehalsen for AI-ydelse. Hurtig compute uden hurtig hukommelse er som en racerbils motor, der sidder fast i første gear. Samsungs fremrykning af HBM4 i produktion kan give Nvidia—og dem, der køber disse acceleratorer—a en betydelig gennemstrømningsfordel.

Hvad er HBM4, og hvordan adskiller det sig?
HBM4 (High Bandwidth Memory 4) er næste udvikling i højtydende, stakket DRAM, designet til at levere betydeligt højere båndbredde pr. pin og større kapaciteter pr. pakke sammenlignet med HBM3 og HBM3E. Arkitekturen bygger videre på 3D-stakning, gennem-silicium-via (TSV) og avanceret interposer-integration, men introducerer forbedringer i signaling, termisk styring og energioptimering for at imødekomme kravene fra moderne AI-acceleratorer.
Tekniske fordele ved HBM4
- Øget båndbredde: HBM4 vil normalt tilbyde højere GB/s pr. stack, hvilket reducerer hukommelsesflaskhalse i store neurale netværk.
- Lavere latenstid: Forbedret hukommelsesarkitektur og tættere integration mindsker adgangstider for store modeller.
- Bedre energieffektivitet: Højere båndbredde pr. watt gør det muligt at skalere AI-ydelse uden proportionalt højere strømforbrug.
- Større kapacitet: Flere lag og optimerede dies øger den samlede capacity per stack, hvilket er vigtigt til store parametermodeller.
Disse tekniske gevinster kombineres til at gøre HBM4 attraktivt for acceleratorer, der prioriterer throughput (pr. chip) og total trænings- eller inferenskapacitet pr. rack.
Nvidia, Vera Rubin og betydningen for generativ AI
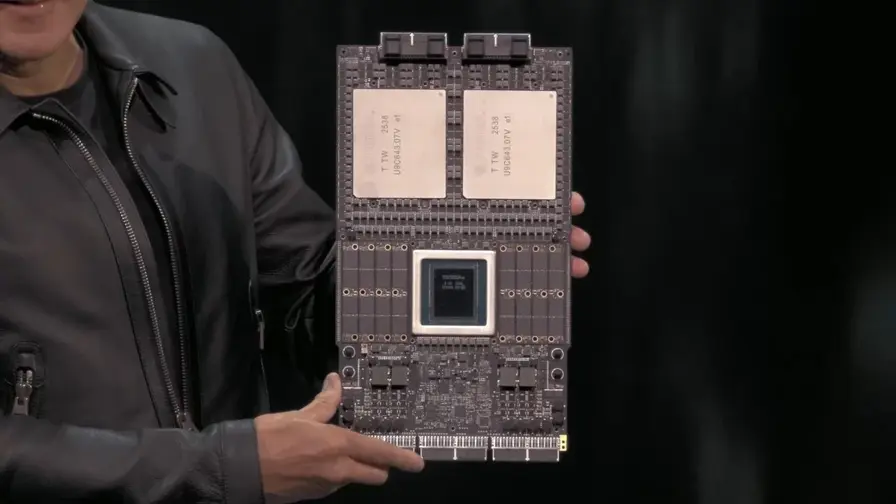
Nvidia har gennem de senere år været en dominerende aktør inden for AI-acceleratorer, og hver ny arkitektur kræver tæt samspil mellem compute- og hukommelsesleverandører. Vera Rubin-arkitekturen rapporteres at være optimeret til generativ AI-workloads på hyperscaler-niveau—en type opgaver, der stiller ekstreme krav til både båndbredde og lav latenstid.
Hvorfor Vera Rubin sandsynligvis har brug for HBM4
Generative modeller, især dem med milliarder til trillioner af parametre, kræver hurtig adgang til store mængder vægt- og aktiveringsdata. Hvis hukommelsesbåndbredden ikke kan følge med compute-ytelsen, bliver GPU- eller accelerator-kjerner underudnyttet. HBM4 kan mindske denne ubalance ved at levere mere data pr. sekund tættere på core'en—det perspektiv er centralt i vurderingen af acceleratordesigns som Vera Rubin.
Markedets leverandørlandskab: Samsung versus SK Hynix og Micron
Indtil nu har SK Hynix og Micron været førende i HBM3E-markedet. Samsung lå lidt efter med HBM3 og HBM3E, men det ser ud til at ændre sig. Flere kilder siger, at Samsung har bestået Nvidias endelige valideringstest og har modtaget tidlige ordrer, hvilket har ført til en produktionskaldens tilpasning direkte til Nvidias tidslinje. Investeringer blev foretaget, kapacitet blev udvidet. Resultatet: Samsung kan være først til at sende HBM4 i stor skala.
Hvis Samsung begynder at sende HBM4 denne måned, kan det ændre HBM-leverandørkortet for AI-infrastruktur.
Konsekvenser for leverandørdiversitet og prissætning
En tidlig masseproduktion fra Samsung kan få flere konsekvenser:
- Prispress: Øget udbud kan midlertidigt dæmpe priserne, men samtidig kan premium HBM4-varianter fastholde høj pris pga. differentieret ydelse.
- Forsyningskonkurrence: SK Hynix og Micron vil sandsynligvis accelerere egne ramps for at bevare markedsandele.
- Købsaftaler og langvarige kontrakter: Store kunder som Nvidia, Amazon og Google kan sikre sig kapacitet gennem langfristede kontrakter for at minimere forsyningsrisici.
Indflydelse på cloud- og hyperscaler-strategier
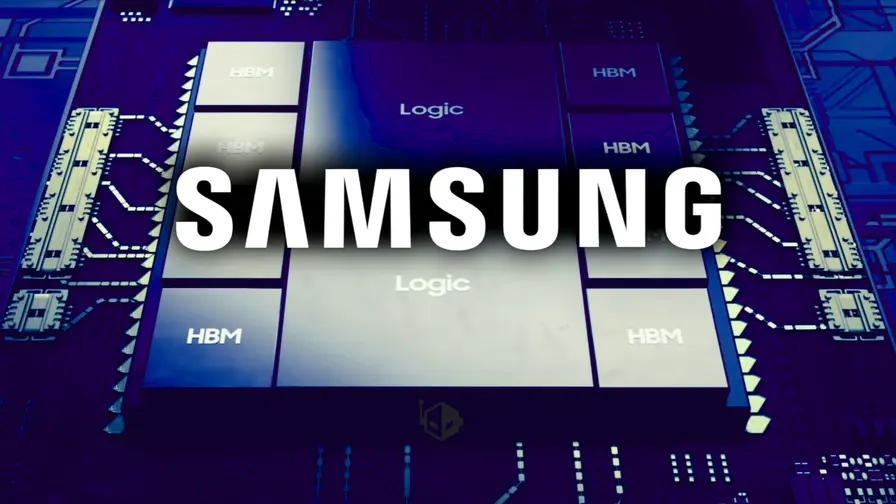
Ud over Nvidia har bevægelsen bredere konsekvenser for cloud-leverandører som Amazon og Google. Begge virksomheder designer egne acceleratorer eller tilpassede varianter til deres cloudtjenester. Adgang til en stabil HBM4-forsyning kan ændre hardware-roadmaps og indkøbsstrategier i hele cloud-økosystemet.
Mulige scenarier for Amazon og Google
- Tidlig adgang: Hvis Amazon eller Google får tidlig adgang til HBM4, kan de optimere egne acceleratorer til lavere latenstid og højere throughput.
- Skift i leverandørvalg: Cloud-udbydere kan vælge leverandører baseret på leveringssikkerhed snarere end kun pris eller ydelse.
- Vertikal integration: Øget samarbejde mellem chipdesignere og hukommelsesproducenter kan føre til mere skreddersyede løsninger, specielt for store, interne modeller.
Tekniske, logistiske og kommercielle risici
Selvom nyheden om Samsungs HBM4-rampe er optimistisk, er risiciene reelle. Produktionsfejl, yield-problemer, logistiske udfordringer i forsyningskæden eller kraftige ramps fra konkurrenter som SK Hynix eller Micron kan ændre billedet hurtigt.
Specifikke risikopunkter
- Yield-udfordringer: Avancerede stakprocesser kan have lavere indledende yield, hvilket begrænser leverbar kapacitet.
- Termisk design: Øget tæthed og hastighed stiller krav til køling og serverdesign—ikke alle kunder kan integrere HBM4 uden systemændringer.
- Forsyningskædeforstyrrelser: Råmaterialer, testudstyr eller interposer-komponenter kan blive begrænsende faktorer.
- Konkurrenternes takt: Hurtigere ramp fra konkurrenter kan udhule en initial fordel.
Hvordan HBM4 kan påvirke AI-ydeevne i praksis
At levere høj båndbredde er kun én side af ligningen. HBM4s struktur og integration påvirker også konsistens i latency, error rates og systemstabilitet—aspekter, der er kritiske i produktionstjenester for generativ AI.
Praktiske effekter på træning og inferens
- Træning: Hurtigere datafeed til compute-klynger kan reducere wall-clock tid for store træningsjob og dermed operativt TCO (Total Cost of Ownership).
- Inferens: Mindre latenstid og bedre throughput pr. accelerator kan forbedre svartider og skalerbarhed for online generative applikationer.
- Modelstørrelser: Større hukommelsespakkekapacitet muliggør latent arbejde med større batch-størrelser og større modelsharding.
I praksis betyder det, at en datacenteroperatør med HBM4-acceleratorer kan levere flere inference-forespørgsler pr. rack og træne større modeller hurtigere pr. dollar brugt på infrastruktur.

Teknisk sammenligning: HBM3E vs HBM4 (højdepunkter)
Mens HBM3E allerede leverer betydelige forbedringer i forhold til HBM3, repræsenterer HBM4 både kvantitative og kvalitative forbedringer. Her er nogle centrale områder, hvor HBM4 forventes at adskille sig:
- Båndbredde pr. pin og pr. stack: Forbedringer i signaling og I/O.
- Energi pr. operation: Bedre PPA (Power, Performance, Area) målinger, som er afgørende for datacenterøkonomi.
- Kapacitet: Flere lag eller større dies pr. stack = højere samlet kapacitet.
- Kompatibilitet: Nye controller- og PHY-opgraderinger for fuld udnyttelse af HBM4-hastigheder.
Det er vigtigt at bemærke, at reelle ydelsesgevinster i et driftsmiljø afhænger af systemintegration, køling og softwarestack-optimeringer, ikke kun hukommelseschips alene.
Produktionstidslinje og markedsdynamik
Rapporter peger på, at Samsung har justeret sin produktionskaldens for at matche Nvidias tidslinje. Det indebærer omfattende koordinering: valideringstests, tidlige ordrer, kapacitetsopbygning og supply-chain synkronisering.
Hvad betyder en tidlig masseproduktion?
En tidlig masseproduktion betyder, at accelerator-leverandører kan begynde at modtage komponenter hurtigere end tidligere forventet. Det kan forkorte tiden fra arkitektur-lancering til bred installation i datacentre fra kvartaler til uger eller måneder—afhængig af logistik og kundeadoption.
Langsigtede konsekvenser for datacentre og AI-økosystemet
Hvis HBM4 rulles ud i stor skala, kan vi forvente flere industrielle effekter:
- Hurtigere iterationshastighed for hardware: Accelerator-designere vil presse grænserne for, hvad der er muligt med lavere latenstid og højere throughput.
- Øget fokus på hukommelsesarkitektur i systemdesign: Ikke kun GPU-kernerne, men også hukommelsesunderstøttelse og interposer-teknologi bliver afgørende konkurrenceparametre.
- Accelereret innovation i softwareoptimering: Frameworks og runtime-systemer til træning og inferens vil justere for at udnytte højere båndbredde effektivt.
Konklusion og hvad man skal holde øje med
Der er naturligvis usikkerheder—yield-problemer, forsyningskædeudfordringer eller konkurrerende vejramper fra SK Hynix og Micron kan ændre landskabet. Men Samsungs bevægelse indikerer en større trend: hukommelsesinnovatorer accelererer for at følge den grådige appetit fra generativ AI. Forvent strammere tidslinjer, dybere leverandørsamarbejde og hurtigere iteration, efterhånden som en ny hukommelsesgeneration lander i datacentre.
Hold øje med de kommende uger. Hardware, som tidligere tog kvartaler at sive ind i infrastrukturen, kan nu ændre magtbalancen næsten natten over.

"Softwareudvikler med en passion for nyheder. Jeg skriver om kodning, open source og cyber-sikkerhed."
Diskussion
Skriv en kommentar
Kommentarer (2)
Er det for godt til at være sandt? Yield, interposer og logistik kan ødelægge festen, og hvem står tilbage med regningen hvis priserne falder? vil se flere kilder
Wow, det her kan virkelig rykke ved AI-hardware. Hvis HBM4 leverer som lovet, kan Nvidia og cloud-giganter få kæmpe fart på... men lidt nervøs for yield og køling, det kan floppe