
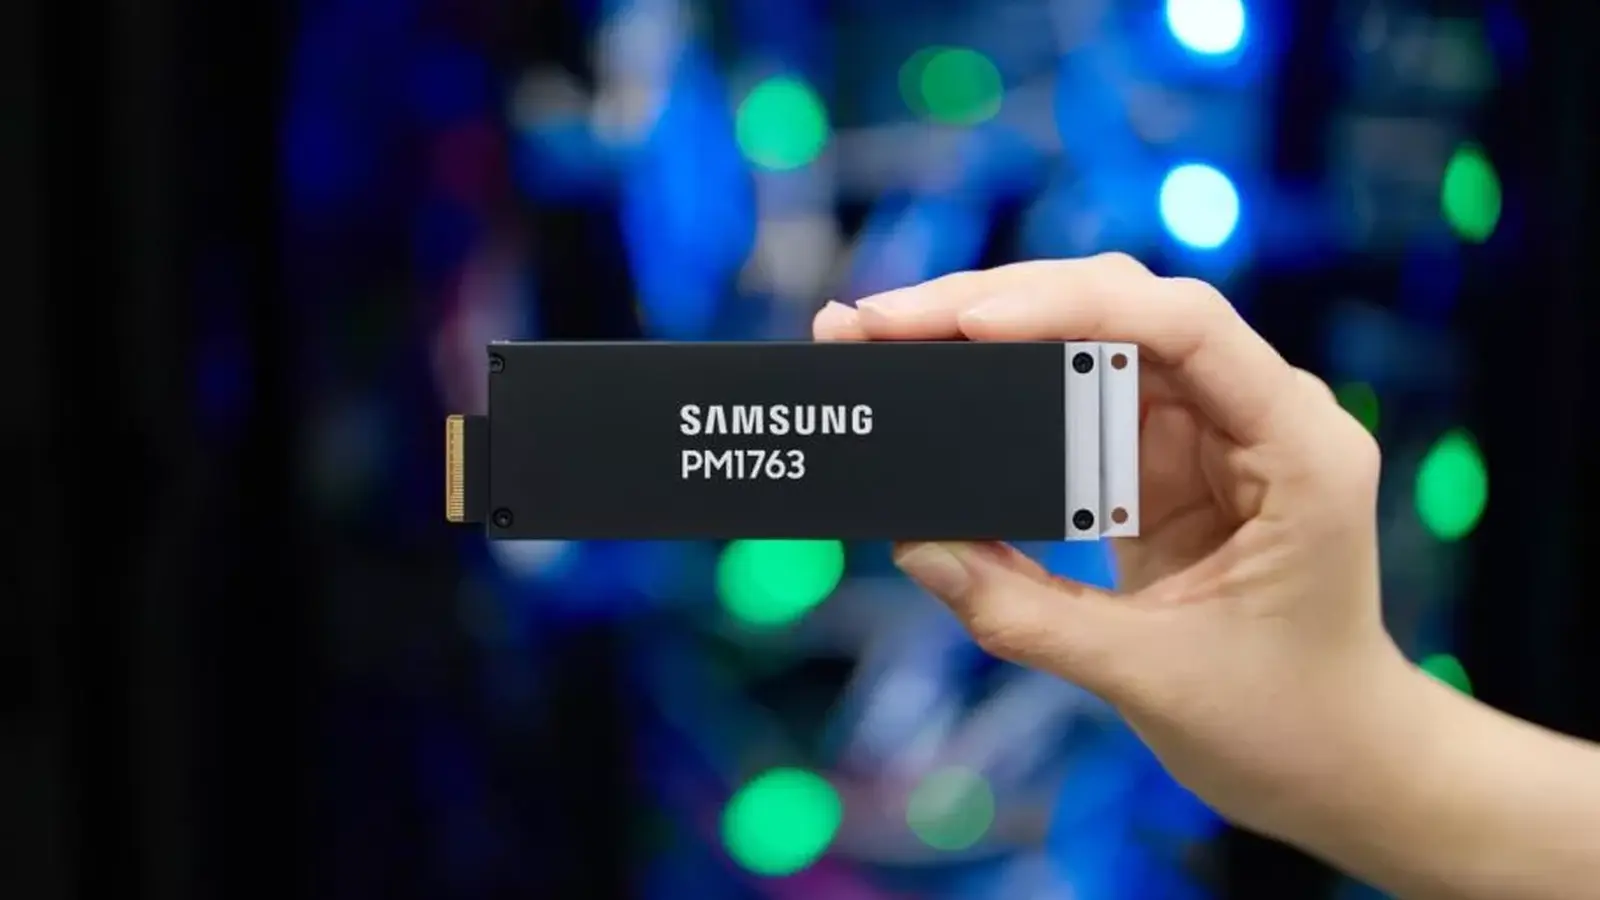
Forestil dig et datacenter hvor lagring ikke længere er flaskehalsen for de mest avancerede AI-modeller. Den fremtid tog netop et håndgribeligt skridt fremad. Samsung Electronics er begyndt masseproduktion af sin PM1763 SSD, bygget på PCIe 6.0 og optimeret til næste generation af AI-servere og højtydende computing-platforme som NVIDIA Vera Rubin.
Datamængder til AI-træning og inferens vokser eksplosivt. Hurtig og konsekvent adgang til disse data er nu lige så afgørende som de GPU'er og acceleratorer, der udfører beregningerne. Samsung imødegår det behov med en enhed, der kombinerer niende generation V-NAND med en nyudviklet 4 nanometer-controller, en kombination der øger både gennemstrømning og energieffektivitet.
Hvad PM1763 tilfører racken
Tilgængelig i 4, 8 og 16 terabyte kapaciteter, gør PM1763 krav på rå hastighed. 16 terabyte-modellen når sekventielle læsehastigheder på op til 28.400 MB/s og sekventielle skrivehastigheder på op til 21.900 MB/s, ifølge Samsung. Det er mere end dobbelt så hurtig ydeevne som den forrige PM1753-generation.
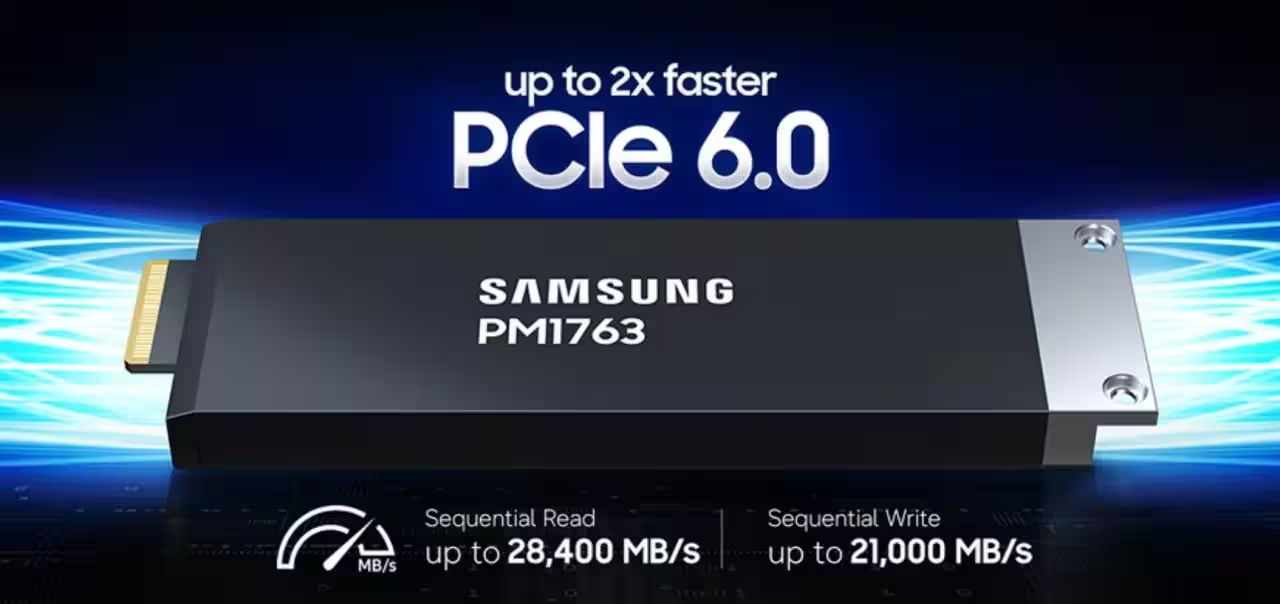
Samsung siger, at en 40 gigabyte stor sprogmodel kan flyttes på cirka 1,4 sekunder, hvilket reducerer datalatensen mellem processorer og acceleratorer og forbedrer den samlede AI-gennemstrømning.
Der ligger ingeniørmæssige detaljer bag de store tal. Enheden understøtter direkte chip-køling, hvilket gør den klar til væskekølede servermiljøer, hvor vedvarende arbejdsbelastninger og lange oppetider er normen. Termisk stabilitet under belastning er vigtig for ensartet ydeevne, og Samsung rapporterer også en energieffektivitetsgevinst på over 1,8 gange i forhold til den tidligere generation, hvilket omregnes til lavere driftsomkostninger i stor skala.
Hvad ændrer sig så for AI-implementeringer i virkeligheden? Kortere indlæsningstider for modeller, reduceret I/O-ventetid og evnen til at fodre acceleratorer med større arbejdssæt uden at blokere. I praksis betyder det hurtigere iterationer for udviklere og mere forudsigelig latens ved produktionsinferens.
Lagring er ikke længere et passivt lag i stacken. Det er en aktiv muliggører for hurtigere og tættere AI-beregning. Samsungs PM1763 ligner den slags hardwareopdatering, der vil brede sig gennem datacentre, som kører banebrydende modeller og krævende HPC-arbejdsbelastninger.
Forvent tidlig adoption i hyperscale- og virksomheds-klynger først, efterfulgt af bredere udrulning, efterhånden som systemleverandører integrerer PCIe 6.0 NVMe-enheder i serverdesign. Kapløbet om at fjerne hver millisekund af forsinkelse i AI-pipelines fortsætter, og dette er en betydelig ny pil i buen.

"Digital iværksætter og skribent. Jeg elsker at dele historier om danske startups, der ændrer verden."
Diskussion
Skriv en kommentar
Kommentarer
Ingen kommentarer endnu. Vær den første.