

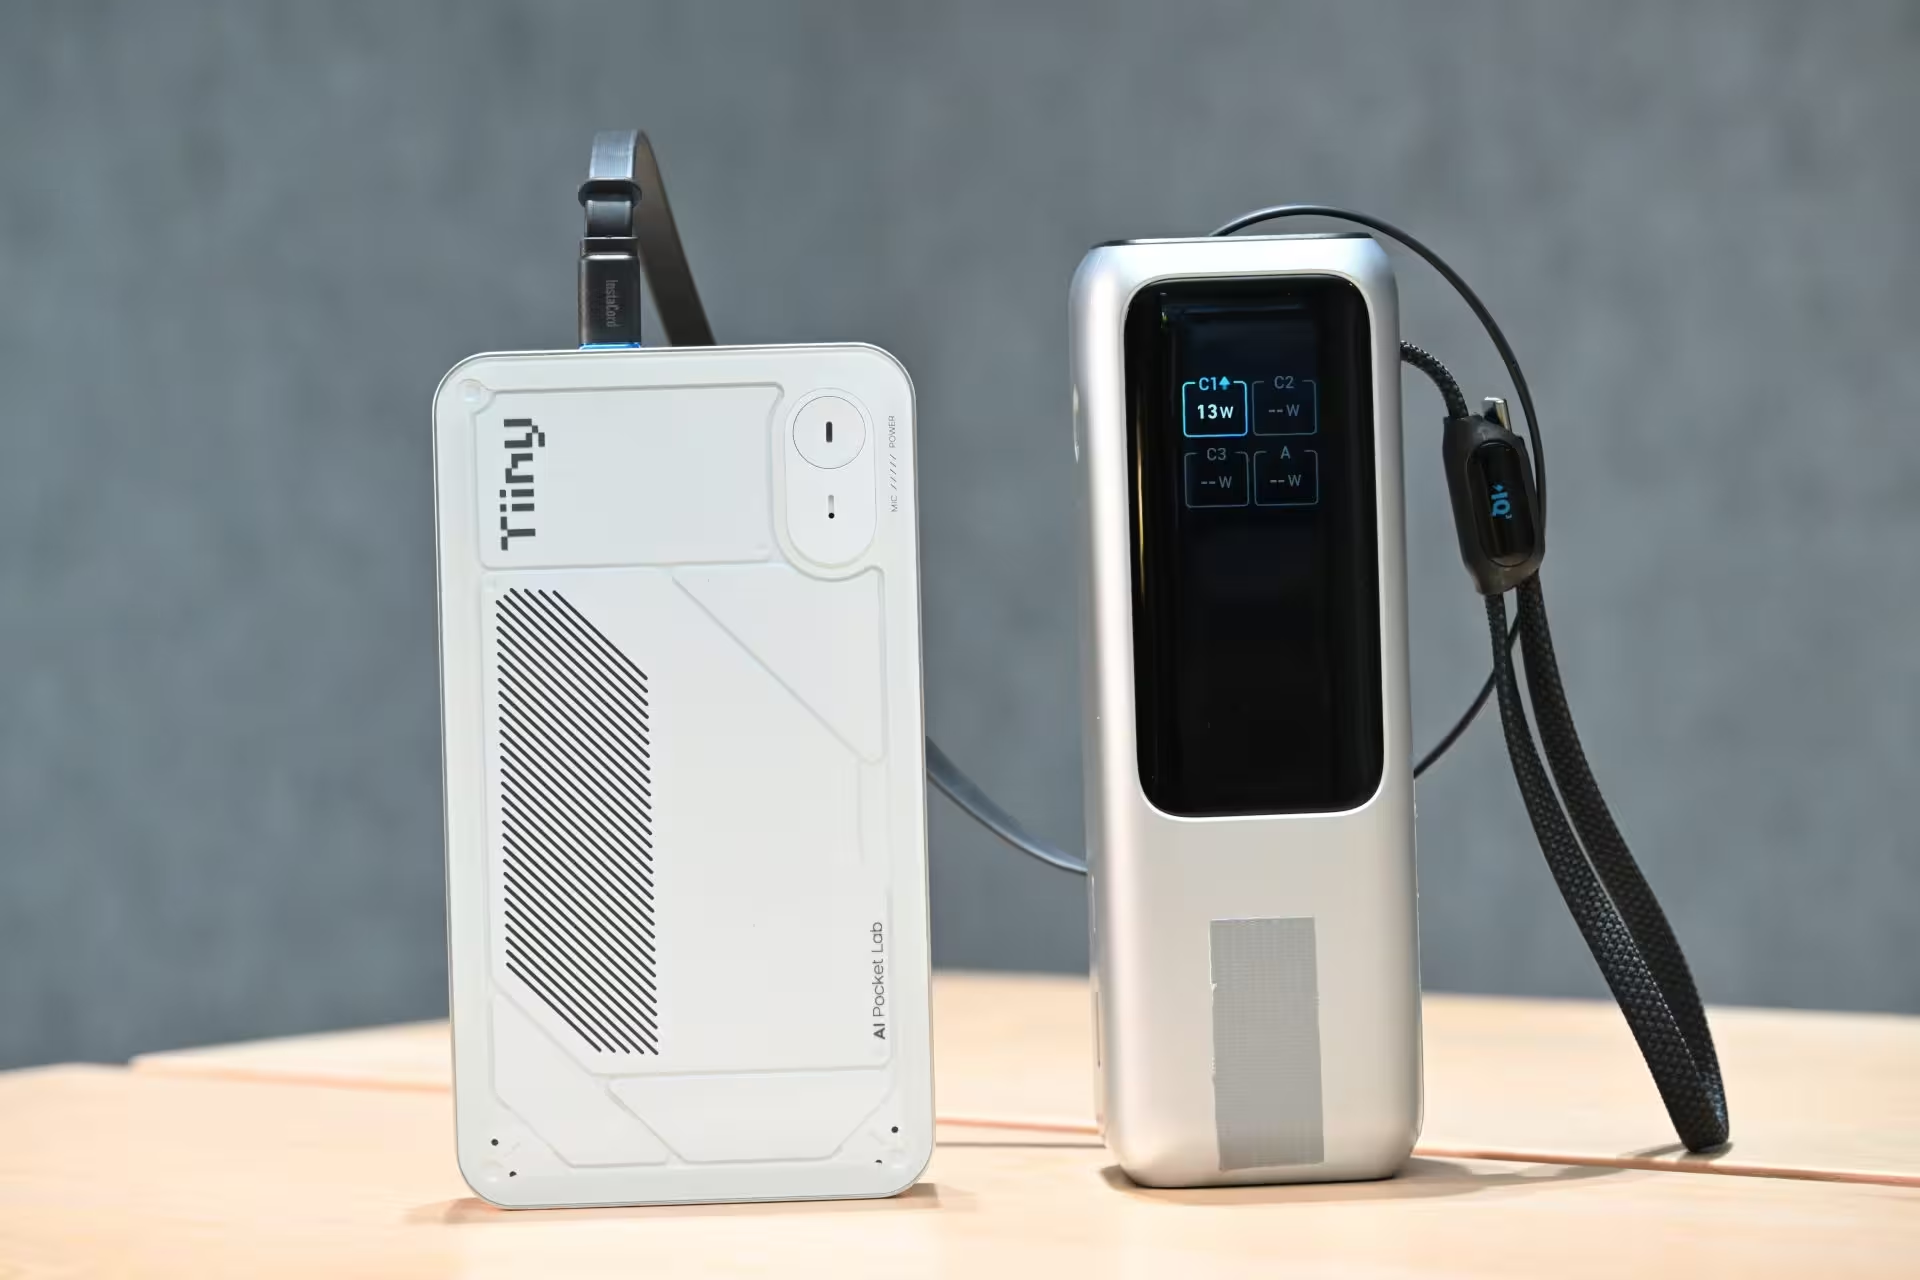
Tiiny AI satser på, at det næste store spring inden for AI-hardware ikke længere kun hører hjemme i datacenteret — det skal kunne bæres i hånden. Startuppet har præsenteret Pocket Lab, en håndfladestørrelse "supercomputer" designet til at køre 120-milliarder-parameter store sprogmodeller (LLM'er) fuldstændigt offline. En sådan enhed sigter mod at kombinere høj ydeevne med lokal behandling, hvilket gør det muligt at køre avancerede naturlige sprogbehandlings-workflows uden netforbindelse, uden løbende cloud-omkostninger og med øget beskyttelse af data og privatliv.
Small device, big claims
Lad dig ikke narre af dimensionerne. Med omtrent 14,2 × 8 × 2,53 cm og en vægt på omkring 300 gram er Pocket Lab konstrueret til at være virkelig bærbar. Alligevel påstår Tiiny AI, at enheden kan huse tunge open-source-modeller, der normalt kræver dyre GPU-klynger. Målet er at levere akademisk niveau-resonnement, komplekse flertrinsanalyser og dyb kontekstforståelse lokalt — uden afhængighed af cloudinfrastruktur. For både udviklere, forskere og virksomheder kan en sådan mulighed ændre arbejdsgange: hurtigere prototyping, færre databevægelser og et stærkere fokus på privatlivsbevaring.
Specs that explain the hype
På papiret læser Pocket Lab som en kondenseret server, men med komponenter optimeret til lavt strømforbrug og høj effektivitet pr. watt. Nogle af de vigtigste tekniske højdepunkter, som forklarer hypen omkring enheden, er:
- ARMv9.2 12-core CPU til generelle beregningsopgaver og systemstyring — en moderne processorarkitektur, der giver bred kompatibilitet og god single-threaded ydeevne til orchestration og pre-/post-processing af data.
- Et specialbygget heterogent compute-modul (SoC + diskret NPU), der leverer omkring 190 TOPS — hvilket muliggør massiv matrix- og tensorinference parallelt med energieffektiv acceleration af neurale netværk.
- 80 GB LPDDR5X-hukommelse og en 1 TB SSD for at give plads til store modelinstanser og hurtig I/O. Den store RAM-mængde er essentiel for at holde de kvantiserede vægte og aktiver lokalt og reducere paginering til lagring.
- Evnen til at køre op til 120B-parameter LLM'er fuldt på enheden ved hjælp af aggressiv kvantisering og hukommelseseffektive eksekveringsstrategier — en nøgle til at bringe store sprogmodeller til edge- og offline-scenarier.
- Power-profil målrettet omkring ~30W TDP og ~65W typisk systemstrøm under belastning — markant lavere sammenlignet med tilsvarende serveropsætninger, hvilket gør enheden egnet til mobile og feltbaserede anvendelser.
- Offline-first drift med one-click deployment for mange open-source LLM'er og agent-rammer, hvilket forenkler installation og eksperimenter for udviklere, der ønsker at arbejde uden cloud-afhængighed.

How does it pull off 120B models in your pocket?
Hemmeligheden bag Pocket Lab er en kombination af høj hardware-tæthed og sofistikeret softwareoptimering. Enheden indeholder en diskret NPU med høj TOPS-kapacitet, men det er også virksomhedens softwareteknikker, som gør store modeller praktiske på relativt begrænset silicium. Konkret bygger løsningen på flere parallelle strategier:
- TurboSparse — en neuron-niveau tilgang til sparsitet i aktivering, der forbedrer inferens-effektiviteten uden væsentlig forringelse af modellens resonneringsevne. TurboSparse reducerer antallet af nødvendige beregninger ved at udnytte, at mange neuroner bidrager lidt til slutresultatet i visse lag og tilstande.
- PowerInfer — en open-source heterogen inferensmotor (populær på GitHub), som dynamisk fordeler arbejdsbyrden mellem CPU og NPU. Motoren orkestrerer beregningerne, så throughput efterligner serverklasse-ydeevne, men ved en brøkdel af det typiske strømforbrug. Den håndterer bl.a. pipelining, batch-fusion og adaptiv kvantisering i realtime.
Kombineret med 80 GB LPDDR5X, som tillader aggressiv kvantisering (fx 4-bit eller sparsede formater) og memory-effektive eksekveringsmønstre, bliver drift af 120B-modeller lokalt plausibelt fremfor blot teoretisk. Praktisk set betyder det, at store modeller kan indlæses i en komprimeret form og køres gennem en række optimerede inferens-trin, hvor hukommelsesbehov, databevægelser og beregningsbåndbredde er nøje afbalanceret.
Models, privacy, and real-world uses
Pocket Lab understøtter et bredt katalog af åbne modeller — fra GPT-OSS og Llama til Qwen, Mistral og Phi — hvilket giver udviklere frihed til at vælge arkitektur efter behov, licens og performancekrav. Fordi enheden opererer fuldstændigt offline, er den attraktiv til privatlivsfokuserede implementeringer, feltforskning og udviklere, der ønsker hurtig iteration uden cloud-latens eller tilbagevendende omkostninger. Lokal inferens mindsker dataeksponering mod tredjepartsservere og kan være et krav i følsomme miljøer som sundheds-, militær- eller industriel automation.
Forestil dig at teste en ny agent-workflow på dit skrivebord, træne eller finjustere modeller med lokale data og derefter køre produktionstjenester i offline-miljøer som fjerntliggende laboratorier, skibe eller sikre faciliteter. Pocket Lab retter sig mod netop denne type brugsscenarier ved at tilbyde enhedssikkerhed, lokal modelkontrol og mulighed for hurtigt at skifte mellem modelarkitekturer og kvantiseringsniveauer for at optimere både nøjagtighed og performance.
What’s next: CES and questions to answer
Tiiny AI planlægger at demonstrere Pocket Lab på CES 2026. Virksomheden har endnu ikke annonceret pris eller leveringsdato, og virkelige benchmarks vil være den afgørende prøve: kan en lommestørrelse maskine konsekvent matche server-grade arbejdsbelastninger i en række forskellige scenarier? Benchmarking bør dække throughput, latens, energiforbrug, temperaturstyring og modelnøjagtighed efter kvantisering for at give et retvisende billede af enhedens kapabiliteter.
Der er flere åbne spørgsmål, som interesserede fagfolk og potentielle købere vil kigge efter svar på: Hvordan skalerer Pocket Lab til kontinuerlig 24/7 drift? Hvad er supportpolitikken for softwareopdateringer og sikkerhedspatches? Hvordan fungerer termisk afsmitning i praktiske use cases, især når enheden udfører længerevarende inferensjob? Og hvordan står enhetens faktisk målte NPU-throughput i forhold til de annoncerede TOPS under realistiske modeller og batchstørrelser?
Selvom disse spørgsmål kræver praktisk afprøvning, signalerer Pocket Lab en spændende udvikling: Edge AI bevæger sig ud over små sensorer og ind i reelt kraftfulde, private compute-platforme. Det kan ændre måden, udviklere, forskere og privatlivsbevidste brugere interagerer med LLM'er ved at tilbyde en platform, der kombinerer stor modelkapacitet, offline-drift og lokal kontrol. For mange applikationer — fra industriel inspektion til medicinsk assistanse og feltbaseret sprogbehandling — kan en sådan kombination være afgørende.

"Softwareudvikler med en passion for nyheder. Jeg skriver om kodning, open source og cyber-sikkerhed."
Diskussion
Skriv en kommentar
Kommentarer (2)
Spændende koncept, men lugter lidt af marketing. 30W TDP i praksis? Accuracy efter 4-bit kvantisering — mister man for meget? Tvivler men håber de overrasker 🤔
Hvis den virkelig kører 120B offline, hvordan håndterer den termisk throttling og 24/7 drift? Lyder vildt, men jeg vil se benchmarks og pris først...